

Когда речь заходит о надёжности цифровых сервисов, большинство сразу вспоминает про аптайм, скорость отклика и стабильность работы. Но чем глубже погружаешься в тему, тем очевиднее становится: настоящая устойчивость невозможна без тесной связки с безопасностью. Раньше эти направления развивались параллельно, словно два отдельных мира со своими инструментами и метриками. Однако реальность облачных сред диктует иные правила — здесь сбой производительности и инцидент безопасности часто оказываются двумя сторонами одной медали.
Мне не раз приходилось наблюдать, как команды, отвечающие за эксплуатацию, и специалисты по кибербезопасности смотрят на одну и ту же систему совершенно разными глазами. Первые видят графики загрузки процессора и задержки сети, вторые — подозрительные попытки входа и аномальный трафик. А ведь данные, которые они собирают, по сути описывают одно и то же состояние инфраструктуры. Именно в этом пересечении и кроется главный потенциал унифицированной наблюдаемости.
Почему разрозненный мониторинг больше не работает
Традиционный подход, при котором мониторинг производительности и контроль безопасности ведутся раздельно, создаёт опасные слепые зоны. Пока одна команда разбирается с деградацией сервиса, другая может не заметить, что эта деградация вызвана целенаправленной атакой. И наоборот — сигнал о подозрительной активности может быть проигнорирован, если он не вписывается в привычную картину эксплуатационных метрик.
Современные платформы наблюдаемости решают эту проблему, объединяя три ключевых потока телеметрии: журналы, трассировки и метрики. Когда все эти данные стекаются в единую систему, появляется возможность увидеть полную картину происходящего. Аномальный скачок потребления ресурсов перестаёт быть просто поводом для проверки производительности — он автоматически становится сигналом для проверки на предмет возможной DDoS-атаки. Неожиданный трафик с неизвестных IP-адресов уже не теряется в общем потоке, а высвечивается как потенциальная попытка несанкционированного доступа.
Такой подход кардинально меняет саму философию реагирования. Вместо того чтобы действовать постфактум, разбирая последствия уже случившегося инцидента, команды получают возможность выявлять угрозы на ранней стадии. Это особенно важно в распределённых облачных средах, где скорость распространения атаки может измеряться секундами.
От обнаружения аномалий к проактивной защите
Наблюдаемость даёт не просто констатацию факта «что-то идёт не так». Она предоставляет контекст, необходимый для понимания причин и масштабов проблемы. Журналы фиксируют последовательность событий, трассировки показывают путь транзакций через систему, а метрики выявляют отклонения от нормального поведения. Вместе эти данные позволяют быстро локализовать источник проблемы и оценить её влияние на критически важные сервисы.
Особую ценность такой подход представляет при выявлении специфических типов угроз. Возьмём, к примеру, эксфильтрацию данных — процесс несанкционированной передачи информации за пределы организации. Классические средства защиты могут не заметить медленную утечку, растянутую во времени. Но система наблюдаемости, отслеживающая паттерны доступа к данным и объёмы исходящего трафика, способна выявить аномалию задолго до того, как ущерб станет критическим.
Аналогичная логика работает и с инсайдерскими угрозами. Сотрудник, который начинает запрашивать доступ к ресурсам, не связанным с его обязанностями, или пытается повысить свои привилегии, оставляет цифровой след. Непрерывный мониторинг поведенческих паттернов позволяет выявить такие отклонения на ранней стадии. То же касается проникновения вредоносного ПО — несанкционированное выполнение кода или аномальное использование ресурсов становятся заметными сигналами для немедленного реагирования.
Ещё один критически важный сценарий — боковое перемещение злоумышленника внутри сети. Когда атакующий пытается перебраться с одной скомпрометированной системы на другую, возникают необычные межсистемные обращения. Наблюдаемость позволяет отследить эти перемещения и заблокировать угрозу до того, как она достигнет критически важных узлов.
Конфигурации и доступ под постоянным контролем
Одной из самых недооценённых, но критически важных функций наблюдаемости является мониторинг изменений конфигурации. Дрейф конфигурации — ситуация, когда фактическое состояние системы отклоняется от запланированного — часто становится первопричиной серьёзных инцидентов. Незамеченное изменение параметров безопасности может открыть уязвимость, которая останется незакрытой месяцами.
Платформы наблюдаемости, отслеживающие изменения в режиме реального времени, позволяют мгновенно реагировать на несанкционированные модификации. Если кто-то изменил правила межсетевого экрана или ослабил параметры шифрования, система немедленно сигнализирует об этом. Команда получает возможность откатить изменение или заблокировать доступ до того, как уязвимость будет использована злоумышленником.
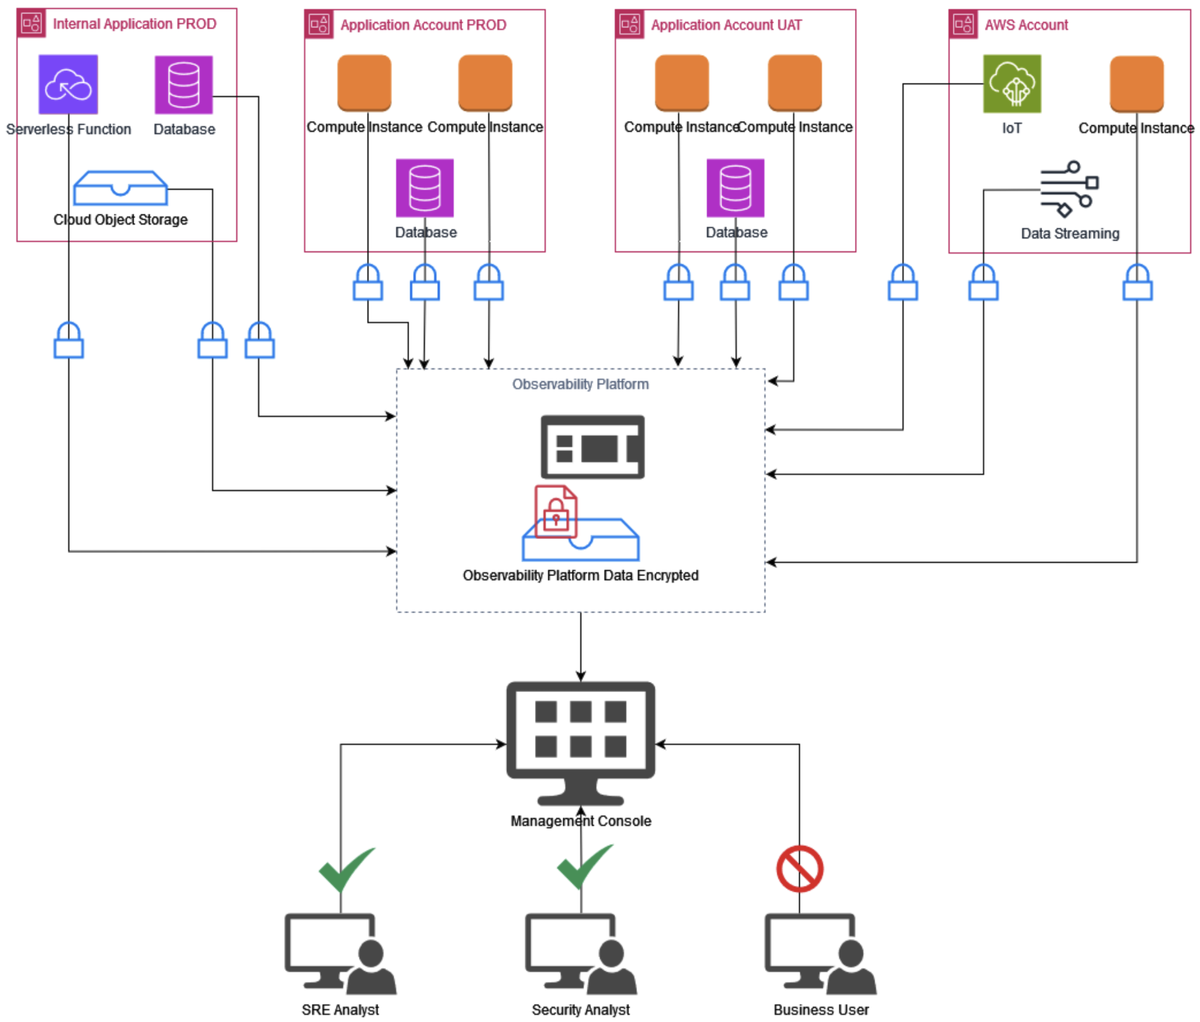
Защита телеметрических данных на всех этапах передачи и хранения — фундаментальное требование для безопасной наблюдаемости
Важно понимать, что сами данные наблюдаемости представляют огромную ценность и должны быть защищены не менее тщательно, чем любая другая чувствительная информация. Журналы и трассировки содержат детальную картину работы системы, которая в руках злоумышленника может стать инструментом для планирования атаки. Поэтому шифрование данных при передаче и хранении, а также строгий контроль доступа на основе ролей — обязательные элементы любой серьёзной платформы наблюдаемости.
Как объединить усилия команд надёжности и безопасности
Технологии — лишь половина решения. Не менее важно выстроить организационное взаимодействие между командами, которые исторически работали изолированно. Мой опыт показывает, что самый эффективный способ — создание совместных информационных панелей, объединяющих показатели производительности с предупреждениями безопасности. Когда обе команды смотрят на одни и те же данные, исчезает почва для недопонимания и задержек в коммуникации.
Интеграция инструментов наблюдаемости с системами управления информацией о безопасности и событиями открывает дополнительные возможности. Сопоставление инцидентов безопасности с событиями надёжности позволяет выявлять причинно-следственные связи, которые иначе остались бы незамеченными. Например, если несанкционированное изменение конфигурации привело к сбою сервиса, объединённые данные позволяют отследить всю цепочку — от момента изменения до последствий для пользователей.
Автоматизация играет здесь ключевую роль. Когда система наблюдаемости обнаруживает подозрительную активность, она может автоматически запускать сценарии реагирования: изолировать скомпрометированные компоненты, блокировать учётные записи, перенаправлять трафик. Такая автоматизация сокращает время реакции с минут до секунд, что в условиях активной атаки может означать разницу между локализованным инцидентом и полномасштабным нарушением.
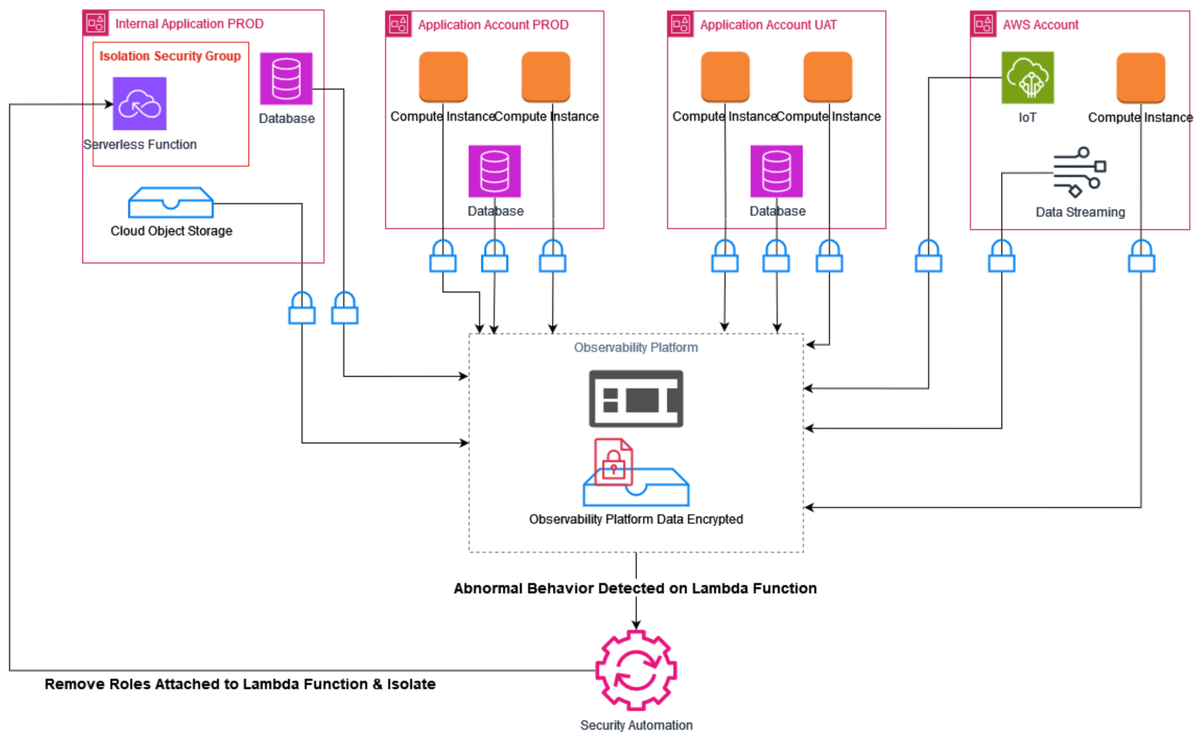
Автоматизированные сценарии реагирования запускаются на основе сигналов наблюдаемости без участия человека
Отдельного внимания заслуживает практика тестирования на проникновение в связке с наблюдаемостью. Традиционные пентесты дают статичную картину уязвимостей на момент проверки. Но когда те же тесты проводятся с включённой наблюдаемостью, команды получают детальную траекторию атаки: какие системы были затронуты, какие данные оказались под угрозой, как быстро распространялось воздействие. Это позволяет не просто закрыть найденные уязвимости, но и понять, как улучшить систему обнаружения для будущих атак.
Практические шаги к безопасной наблюдаемости
Построение эффективного конвейера, объединяющего надёжность и безопасность, требует системного подхода. Первый шаг — сквозная интеграция инструментов наблюдаемости с существующей инфраструктурой безопасности: системами оркестрации, автоматизации, платформами расширенного обнаружения и реагирования. Единая информационная панель, где видны и показатели надёжности, и предупреждения безопасности, становится центром оперативного управления.
Второй важный элемент — использование искусственного интеллекта и машинного обучения для прогнозирования проблем. Анализируя исторические данные, такие системы могут выявлять паттерны, предшествующие инцидентам, и предупреждать о потенциальных проблемах до их возникновения. Автоматические процессы исправления, запускаемые при достижении определённых пороговых значений, позволяют решать проблемы без ручного вмешательства.
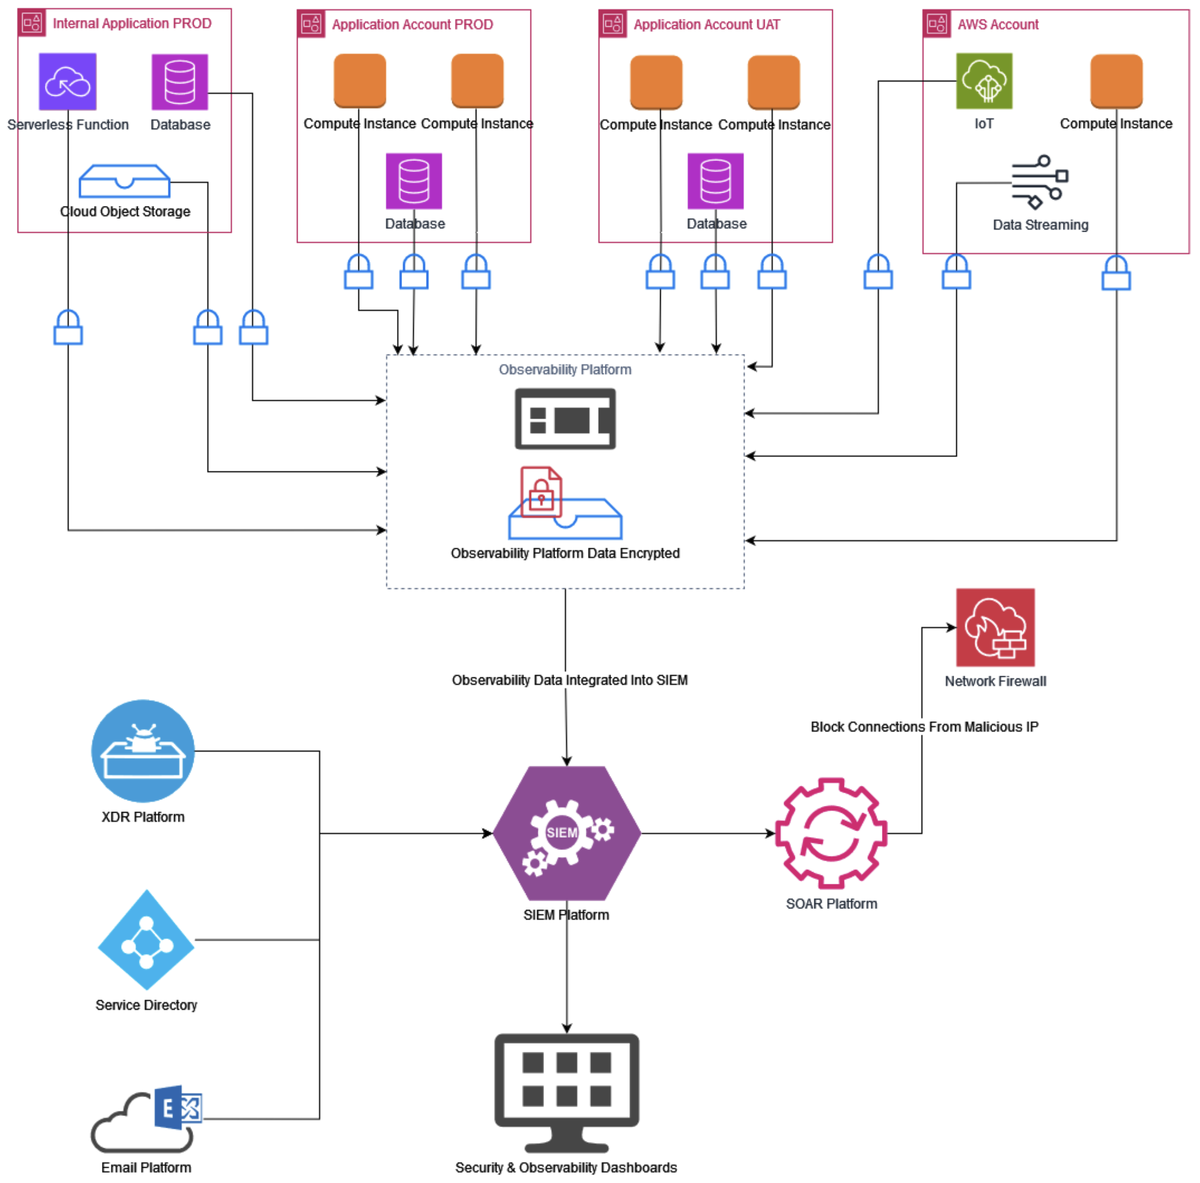
Единая платформа объединяет сигналы безопасности и надёжности для скоординированного реагирования
Третий компонент — настройка специализированных оповещений, учитывающих специфику обеих областей. Важно, чтобы команды получали только значимые уведомления, не утопая в потоке ложных срабатываний. Оповещения должны быть настроены так, чтобы группа надёжности узнавала о проблемах безопасности, влияющих на производительность, а группа безопасности — о сбоях, которые могут указывать на атаку. Такая перекрёстная информированность обеспечивает слаженную работу и быстрое реагирование.
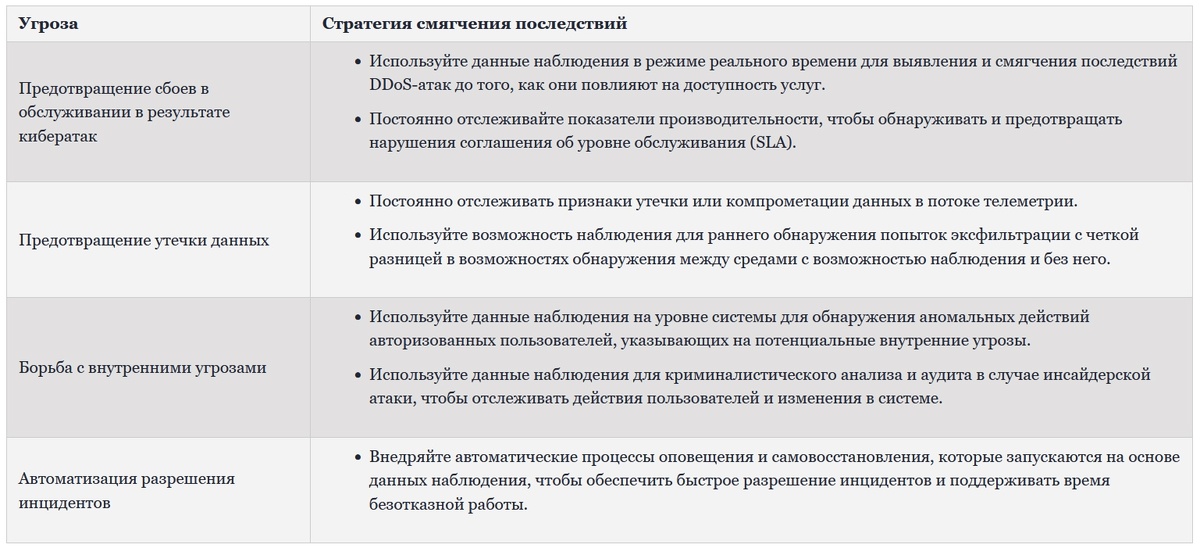
Основные категории угроз надёжности и соответствующие стратегии их нейтрализации через наблюдаемость
Подводя итог, хочу подчеркнуть: интеграция наблюдаемости и безопасности — это не модный тренд, а насущная необходимость для организаций, работающих в облачных средах. Сложность современных систем достигла уровня, при котором раздельное управление надёжностью и защитой становится не просто неэффективным, но и опасным. Унифицированный подход позволяет видеть полную картину, реагировать быстрее и предотвращать инциденты до того, как они нанесут ущерб. В мире, где каждая минута простоя или утечка данных может стоить миллионы, такая интеграция становится ключевым фактором устойчивости бизнеса.


